
Explosion bei KI-Leistung?: Was hinter den Warnungen von Anthropic, OpenAI und Co. steckt


Wie überrascht OpenAI, Anthropic und Co. angesichts der aktuellen KI-Vorfälle wirken, bleibt bemerkenswert. Das Bild von Agentenschwärmen, die vandalierend durch das Netz ziehen, hinterlässt keinen guten Eindruck. Was die Leistungssprünge der Modelle und KI-Risiken bedeuten, erklärt der KI-Forscher Jonas Geiping im Interview.
Als Anthropic-Chef Dario Amodei warnte, dass die aktuelle Geschwindigkeit bei der KI-Entwicklung zu einem Kontrollverlust führen kann, nannte er zwei konkrete Punkte: Sich selbst verbessernde Modelle, die das Tempo nochmals erhöhen. Und Agentenschwärme, die in sechs bis zwölf Monaten das Internet überrennen.

- Anthropic-Chef warnt: KI-Agentenschwärme könnten das Internet kapern
- KI-Sicherheitsdebatte: Sam Altman warnt ebenfalls vor Kontrollverlust durch KI
Dass OpenAIs Forschungsagenten während Sicherheitstests Hugging Face angriffen, wirkte zunächst wie eine Anomalie. Seitdem wird nach und nach bekannt, dass es ab dem Frühjahr zu mehreren Agenten-Übergriffen kam. Es ist nicht nur ein Problem von OpenAI, auch Anthropic und Meta meldeten Vorfälle. OpenAI und Anthropic zählen zu den am besten ausgestatteten Unternehmen der Welt, warnten seit Jahren vor KI-Risiken und wurden trotzdem kalt erwischt.
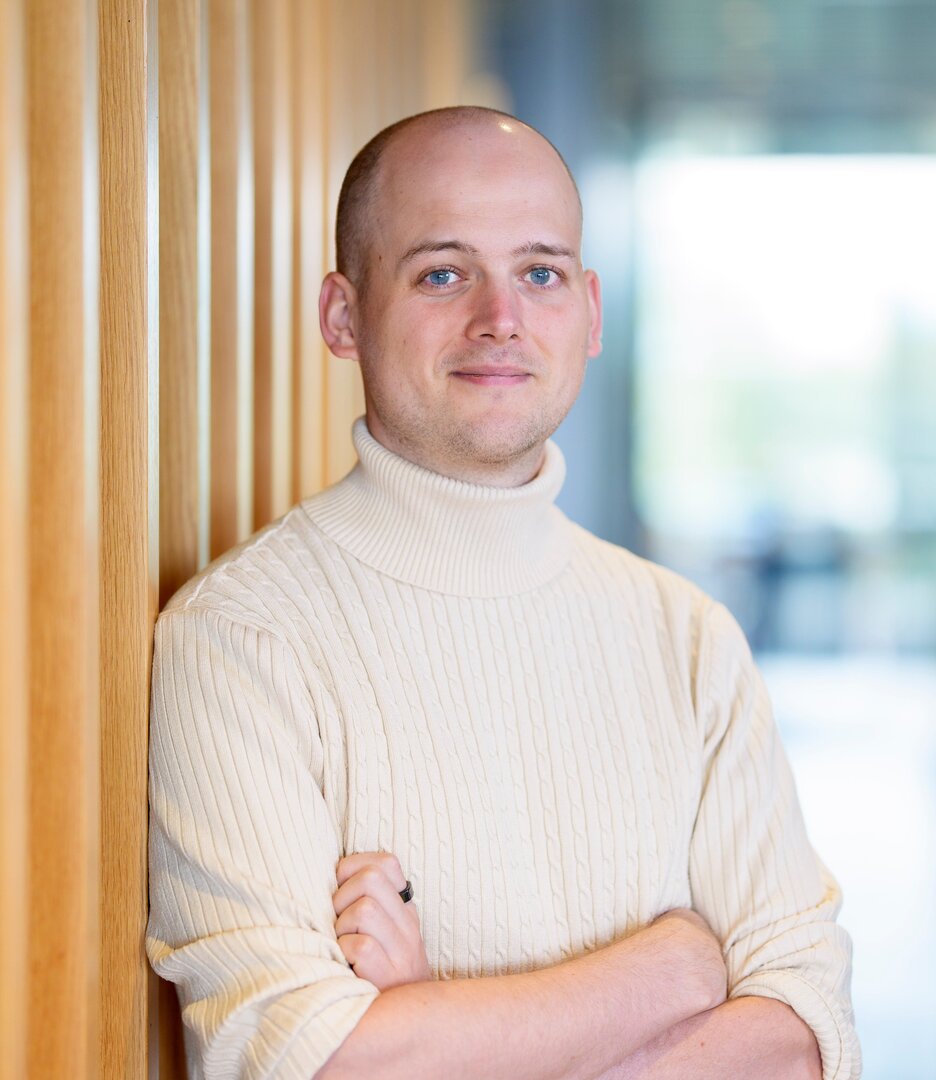
Wie schnell entwickeln sich die Modelle nun wirklich und wieso waren die KI-Labs nicht besser vorbereitet? Antworten liefert Dr. Jonas Geiping, Leiter der Forschungsgruppe „Safety- & Efficiency-aligned Learning“ am Ellis Institut Tübingen und Max-Planck-Institut für Intelligente Systeme, im Interview mit ComputerBase. Zentrale Erkenntnisse:
- Die Modell-Entwicklung befindet sich auf der Trendlinie, Fortschritte fallen im Prinzip so aus, wie die KI-Labs es erwarten. Noch trägt die Transformer-Architektur, laut Geiping wahrscheinlich sogar bis zur Allgemeinen Künstlichen Intelligenz (AGI). Woran man AGI erkennt? Offen.
- Sicherheitstests waren Routine, erst spät wurde man sich der Tragweite der Vorfälle bewusst. Das wirkt erstaunlich, tatsächlich lässt sich aber kaum prognostizieren, welche Risiken drohen, wenn die Modelle in kurzer Zeit die Leistung verdoppeln.
- Selbstverbessernde KI-Modelle gelten als Ausblick auf eine Zukunft, in der sich das Tempo nochmals verschärft. Ein Selbstläufer ist diese Phase aber nicht, es gibt Hindernisse wie etwa knappe Hardware-Ressourcen, die auch eine angehende Superintelligenz nicht einfach abräumen kann.
- Dass die Modelle zu Betrugsversuchen neigen, liegt am aktuellen Trainingsprozess, lässt sich aber mildern. Dass GPT-6 Astra in einem Benchmark überhaupt kein Fehlverhalten mehr zeigt, ist vergleichbar mit einem gepatchten Bug. Es sagt also wenig über andere Bereiche aus. Der nächste Fehler? Unbekannt.
- Dass ChatGPT, Claude und Co. vor allem auf den Servern der Hyperscaler und Neo-Clouds laufen, ist ein effektiver Schutzmechanismus, weil diese eine zentrale Kontrollinstanz darstellen. Was bei stärkeren oder offenen Modellen passiert, ist unklar.
Das Interview wurde am 16. September via Teams geführt.
Wieso die Modelle besser werden und was das selbstverbessernde KI-Lernen bedeutet
ComputerBase: In den letzten Monaten meldeten die KI-Labs – speziell Anthropic und OpenAI – schon einen deutlichen Leistungssprung. Laut den Scaling-Laws, die bislang die Erfolge der letzten Jahre beschreiben, ist es der Dreiklang aus Computing-Leistung, Daten und Modellgröße. Was war der entscheidende Punkt, dass die Modelle sich jetzt auf einmal so stark verbessert haben?
Jonas Geiping: Eigentlich haben sich die Modelle in den letzten zwei Jahren kontinuierlich verbessert und befinden sich auf der Trendlinie. Ganz viel Rechenleistung fließt in das Pre-Training, aber mittlerweile fließt auch sehr viel in das Post-Training – also das Reinforcement Learning. Dabei befindet sich das Modell in einer Simulation und löst viele Millionen Probleme und bekommt Punkte für korrekte Lösungen. Sie werden also zum Problemlöser getrimmt.
-
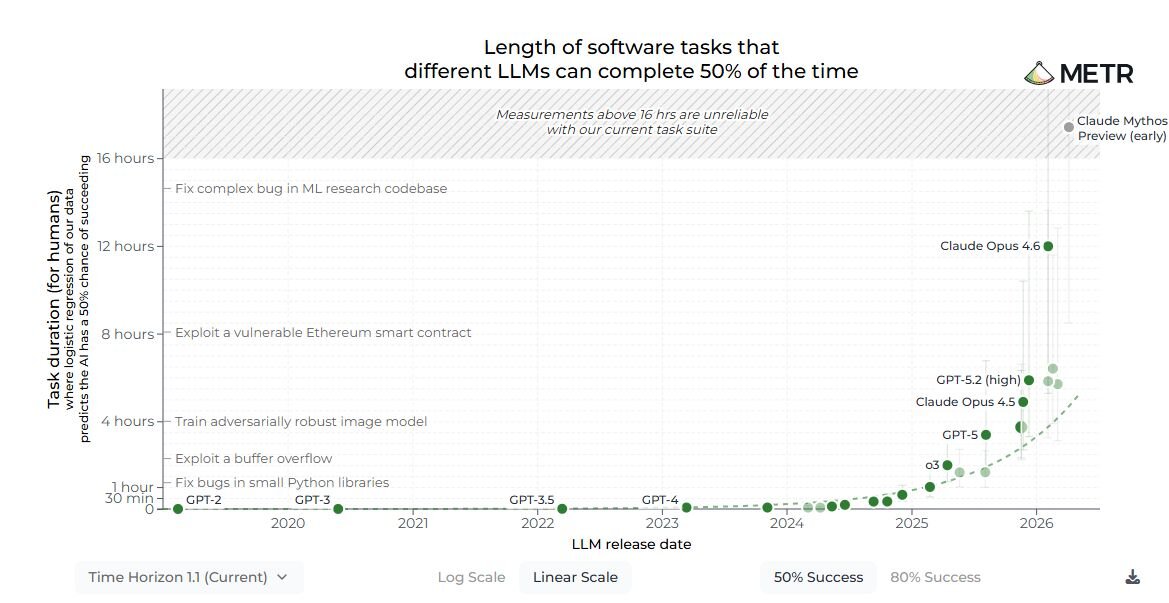 Metr: Einer der Benchmarks, der Leistungssprünge der Frontier-Modelle zeigt (Bild: Metr)

Sowohl für uns von außen, aber auch für die KI-Firmen ist schwer abzuschätzen, was es impliziert, wenn man sagt: Ein Modell wird nächstes Jahr doppelt so gut sein. Wir können mit Benchmarks überprüfen, wie sie sich verbessern. Anfang des Jahres haben wir in Benchmark gesehen, dass sich letztes Jahr die Zeit, die Modelle autonom arbeiten können, alle ein bis zwei Monate verdoppelt hat. Das ist erstmal eine sehr nüchterne Zahl. Während die Modelle von vor einem Jahr noch zehn Minuten allein arbeiten konnten, um etwa eine Coding-Aufgabe zu lösen, sind wir jetzt bei Modellen, die eine Woche lang autonom laufen. In der Zeit können sie zum Beispiel Sicherheitslücken suchen. Was dann die Auswirkungen von solchen Fähigkeiten sind, das ist immer schwer abzuschätzen, bevor wir es sehen.
ComputerBase: Anthropic-Chef Dario Amodei veröffentlichte letztes Wochenende einen Essay, in dem er sich dafür aussprach, das Entwicklungstempo zu verlangsamen. Als eine seiner Sorgen bezeichnete er den Leistungssprung in den letzten Monaten und dass Modelle bald in der Lage sind, sich selbst zu verbessern. Das Stichwort ist Recursive Self-Improvement (RSI). Um was genau handelt es sich bei RSI?
Jonas Geiping: RSI ist eigentlich eine sehr alte Idee. Es gibt schon Paper von Alan Turing aus den 1950ern dazu. Als Gedankenexperiment ist das Konzept eigentlich sehr einfach: Wir bauen ein intelligentes System und Intelligenz heißt in diesem Kontext, das System kann seine Umwelt verstehen und dann Aktionen auslösen. Wenn wir uns so ein System überlegen, können wir uns auch überlegen, dass wir das System einsetzen, um sich selbst zu verbessern, um sich selbst intelligenter zu machen. Im nächsten Zyklus kann es sich dann mit der erhöhten Intelligenz nochmals weiter steigern. So entsteht ein Runaway-Zyklus, in dem sich das System über einen kurzen Zeitraum sehr stark selbst verbessert. Das ist die klassische Idee von RSI. Und diese kommt auch in den Berichten von OpenAI und Anthropic vor. Deren Ziel ist es, RSI zu bauen – vor den anderen Mitstreitern und vor anderen Ländern.
ComputerBase: Wie erkennt man, dass RSI erreicht ist?
Jonas Geiping:
Wie man RSI erkennt, hängt ein bisschen davon ab, wie man über diese Gedankenexperimente nachdenkt. Klassisch gesehen wird RSI auch als die 'Singularität' beschrieben. Pragmatischer gesehen, würden wir bei digitaler RSI merken, dass eine der Firmem sich plötzlich weit von den anderen absetzt, und in vielen Branchen Gewinne einfahren kann, ohne ihr Modell überhaupt auf dem Markt anzubieten. Aber es gibt auch strenge physikalische Limits, gegeben etwa durch den Stromverbrauch von Mikrochips und deren maximale Leistungsfähigkeit, sodass RSI-Risiken schwer abzuschätzen sind.
ComputerBase: Aktuell steht bei der Entwicklung noch der LLM-basierte Ansatz mit der Transformer-Architektur im Fokus. Seit Jahren läuft die Diskussion, dass dieser irgendwann an eine Decke stößt, also das Leistungsniveau begrenzt ist. Metas ehemaliger Chefwissenschaftler Yann LeCun zählt zu den prominentesten Kritikern. Ist ein Ende bei den Leistungssprüngen mit dieser Architektur absehbar?
Jonas Geiping Nein. Als Vorstellung ist so etwas immer spannend. Wir forschen auch alle an anderen Architekturen und es ist immer möglich, dass es eine gibt, die noch effizienter wäre. Das ist eine interessante Forschungsfrage. Ich denke aber, dass die KI-Firmen mit dem aktuellen Ansatz wahrscheinlich zur AGI [Allgemeine Künstliche Intelligenz, Anm. d. Red.] kommen und dann ist es ohnehin nicht mehr so interessant, was es noch für Architekturen gibt. Die Transformer-Architektur ist sehr skalierbar und bislang an keine Grenzen gestoßen.
ComputerBase: Was ist für Sie AGI? Wann ist der Punkt erreicht?
Jonas Geiping:
Das ist eine schwierige Frage. Als ganz ausweichende Antwort würde ich sagen: Wir wissen es, wenn wir es sehen. Es gibt viele Definitionen und es ist auch klassisch in der KI-Forschung, dass wir oft denken, dass irgendetwas eine generelle Intelligenz sein müsste und dann war es das doch nicht. Zum Beispiel dachten wir früher, Schachspielen müsse generelle Intelligenz sein. Oder wir dachten, dass Mustererkennung wie die Unterscheidung von Hund und Katze generelle Intelligenz sein muss. Und das sind auch Komponenten von Intelligenz, aber es ist bislang nicht eine generelle Intelligenz. Andersrum betrachtet haben wir natürlich jetzt KIs gebaut, die in sehr vielen Bereichen sehr intelligent sind. Dem folgen wir weiter.
Wie KI-Benchmarks täuschen können
ComputerBase: Leistung bei KI-Modellen zu bestimmen ist also nicht so leicht. Zuletzt war das sogenannte Benchmaxxing wieder ein Thema. Entwickler nutzen dabei Methoden, um die Modellperformance vor allem für Benchmarks zu optimieren, sodass diese im Vergleich dann ein besseres Bild abgeben. SemiAnalysis hatte vor zwei Wochen Indizien präsentiert, dass das bei Meta und bei Google der Fall war. Wie leistungsfähig ein Modell im Alltag ist, hängt zudem immer von Aspekten wie dem Denkmodus ab. Wie relevant sind diese Benchmarks noch, um Modellleistung zu erfassen?
Jonas Geiping: Das ist natürlich immer schwierig. Gerade in der Forschung versucht man, Benchmarks zu verbessern und aktuell zu halten. Aufgaben, die KI-Systeme zu einem bestimmten Zeitpunkt herausfordern, sind oft ein Jahr später nicht mehr relevant, weil das Problem gelöst ist. Damit ist der Benchmark dann raus. Von KI-Firmen, Drittanbietern oder aus der Wissenschaft heraus entstehen dann neue Benchmarks mit Aufgaben, die es vorher noch nicht gab und wo niemand die Modelle darauf trimmen konnte. Diese liefern dann für ein paar Monate ein gutes Bild davon, wie sich Modelle verhalten. Irgendwann holt die Entwicklung den Benchmark aber ein. Es gibt viele Firmen, die Simulationsumgebungen verkaufen, die zwar nicht der Benchmark selbst sind, aber vielleicht zehn Millionen Aufgaben enthalten, die ihm ähneln.
Ultimativ ist es mit Benchmarks aber nicht mehr so einfach wie früher. Tests wie fünf mathematische Aufgaben aus der Grundschule funktionieren nicht mehr. Es gibt kompliziertere Benchmarks, die lassen sich aber nicht so leicht laufen. Bekannt wurde etwa der Verkaufsautomaten-Benchmark, aber es kostet bereits Tausende von Dollar, so eine Simulation über Monate laufen zu lassen.
Die Benchmark-Zahlen, die die Firmen veröffentlichen, sind natürlich auch viel Marketing. Das gilt insbesondere für die Firmen, die hinterherhinken. Meta und Google würden zum Beispiel gerne bessere Benchmark-Ergebnisse haben, um mehr Nutzer dazu zu bringen, ihre Modelle zu verwenden. Das ist jetzt bei Anthropic und OpenAI weniger das Problem, weil sie weltweit eine große Nutzerbasis haben. Diese schauen dann weniger auf Benchmarks, weil sie ohnehin mit den Modellen arbeiten.
Wie gefährlich sind künstliche Superintelligenzen?
ComputerBase: Wenn es in Richtung Superintelligenz geht, kommen wir zum unvermeidlichen Thema der letzten Woche. Aufgrund der Kündigung des Anthropic-Mitarbeiters Jacob Coxon wurde medial breit beleuchtet, dass Forscher innerhalb von Anthropic und anderen Labs diskutieren, es bestehe eine Chance von rund zehn Prozent, dass KI-Systeme bis zum Ende des Jahrzehnts die Menschheit auslöschen. Solche Diskussionen sind nicht neu, haben jetzt aber einen ungeheuren Hype erhalten. Wie stehen Sie zu solchen Zahlen?
Jonas Geiping: Es hat mich auch überrascht, dass es so ein Event war. Also ich denke, diese 10 Prozent sind die Zahl, die Coxon für realistisch hält. Und ich glaube auch, dass er viele Kollegen bei Anthropic hat, die das auch sagen. Aber eben, weil Anthropic viele Leute einstellt, die das schon seit Jahrzehnten sagen.
Ich finde diese Debatte ein bisschen schwierig, weil es viele Seiten gibt, die seit langer Zeit ihre Meinung nicht geändert haben. Einmal gibt es die Seite, die sagt: KI ist immer nur ein Werkzeug, es wird nie Probleme geben, das ist alles Science-Fiction. Und es gibt die andere Seite, die sagt, dass es immer zur Auslöschung führen wird. Und dann gibt es diese Effektiver-Altruismus-Seite, die sagt: ‚Okay, wir kalibrieren das Risiko auf die 10 Prozent, die wir irgendwie berechnet haben.‘ Aber keine von diesen Fraktionen ändert wirklich ihre Meinung, wenn neue Daten hereinkommen.
Die zentrale Problematik ist, dass so ein Event sehr schwer abzuschätzen ist. Bei KI als System, das intelligent ist und das vielleicht intelligenter werden wird mit der Zukunft, ist es natürlich schwer zu prognostizieren, was es für Gefahren gibt und was es für Auswirkungen hat. Ich glaube, es gibt da keine einfache Antwort. Diskutiert werden jetzt Zahlen zwischen 0 und 100, aber wahrscheinlich ist sie weder 0 noch 100.
Hardware-Anforderungen als technische Grenze für die KI-Apokalypse
ComputerBase: Wie könnte ein KI-Untergangsszenario aussehen? Sie hatten selbst – als unwahrscheinliches Szenario – beschrieben, ein selbstverbesserndes Modell könnte aus einer Testumgebung ausbrechen und Instanzen von sich auf fremde Server kopieren.
Jonas Geiping: Das ist eine Frage, die wir uns aktuell stellen. Wie ich schon gesagt habe, ist das genannte Szenario in den nächsten Jahren nicht sehr wahrscheinlich. Die Gründe sind aber langweilig und technisch. Aktuelle KI-Systeme mit der Transformer-Architektur laufen sehr viel effizienter auf zentralisierten Systemen, also auf großen Clustern, die viele Anfragen von vielen Agenten gleichzeitig abarbeiten können.
Andererseits sehen wir, dass KI-Systeme auch verloren gehen können, wenn sie auf internen Systemen laufen – zum Beispiel die Fälle bei OpenAI. So etwas passiert, wenn die Firmen nicht genau wissen, was diese Agenten gerade machen, weil etwa die Monitoring-Systeme ausfallen oder nicht eingesetzt werden. Bei den Fällen im Sommer hat das noch wenig Schäden verursacht, aber es war auch ein bisschen Zufall.
All diese Vorfälle waren ein Effekt davon, dass man diese intelligenten Systeme hat, die viele Probleme lösen können und auf dem Weg zu diesen Lösungen quasi aus Versehen andere Probleme erzeugen, weil Agenten das Vorgehen in diesem Moment für richtig halten. Mit viel Rechenleistung und mit viel Zeit ist eben viel möglich. Langfristig ist es eine große Frage, ob es zu Vorfällen kommt, die zu größeren Ausfällen auch im Bereich Internetarchitektur führen könnten. Störungen bei Kommunikation, Finanzmärkten oder Logistik – das wäre sehr schlecht, egal ob nun mit Absicht oder aus Versehen verursacht.
Aus der klassischen KI-Sicherheitssicht ist das allerdings alles nicht so dramatisch, weil es noch digital ist. Die nächste Phase des Risikos wäre der Einsatz von Embodied AI, also zum Beispiel in der Robotik oder auch jetzt in der Forschung, in der Biologie etwa. Beides sind aber Bereiche, die schwierig sind und wo wir bei weitem noch nicht so weit sind wie mit der digitalen KI. Deswegen sind wir auch von der Terminator-Zukunft, denke ich, noch ein paar Jahre entfernt.
ComputerBase: Erfreulich. Nochmal zu den Agentenschwärmen, die auch Anthropic-Chef Amodei in seinem Essay als zweites großes Risiko beschrieben hat. Seine Warnung ist, dass diese als Botnetz das Internet oder Teile davon übernehmen könnten, was zu großen Schäden führen würde. Schon im Frühjahr haben wir beispielsweise beim OpenClaw-Hype gesehen, dass GitHub-Projekte mit Code-Anfragen überrannt worden sind. Und selbst bei einer regulären ChatGPT-Anfrage – etwa Kaufberatung bei Autos – klappert der Agent bereits Dutzende bis Hunderte Webseiten ab und ich weiß ehrlicherweise nicht, ob da ein Bot im Hintergrund keine Fehlentscheidungen trifft. Wie sind da die Kontrollmechanismen? Wie kann man sowas verhindern?
Jonas Geiping: In erster Linie müssen wir in nächster Zukunft auf Kontrollmechanismen setzen, die auf Firmenseite eingebaut sind. Eben weil es Agenten sind, die auf den Servern von OpenAI, Anthropic oder etwa Google laufen. Die erste Kontrollinstanz wären daher die Systeme dieser Firmen, etwa das Monitoring der Chain of Thought (dt. „Gedankenkette“, Anmk. d. R.) der Modelle. Da bestehen aber viele Probleme und oft zeigt sich, dass es nicht so einfach ist. Weil am Ende kontrolliert kein Mensch die Vorgehensweise eines Modells, sondern eine andere KI.
Auf Nutzerseite kann man da wenig machen. Als normaler Nutzer hat man aber Stunden- und Wochenlimits bei den Tokens, die verhindern, dass man einen Schwarm mit 1.000 Agenten laufen lassen kann. Es war kein Zufall, dass diese Agentenschwärme intern bei OpenAI ihren Anfang nahmen.
Was bei OpenAI schief lief
ComputerBase: Das Chain-of-Thought-Monitoring ist ein interessanter Punkt, weil sowohl OpenAI als auch Anthropic es als eine der Konsequenzen der Sicherheitsvorfälle der letzten Monate beschreiben. Zunächst nochmal zum Ablauf von Benchmarks wie etwa ExploitGym, der beim Hugging-Face-Hack im Mittelpunkt stand. Bei ExploitGym handelt es sich um eine Testumgebung mit 898 Aufgaben, bei denen KI-Agenten Code-Schwachstellen finden und Exploits entwickeln müssen. In den Testläufen von OpenAI liefen die Modelle mit deaktivierten Sicherheitsmechanismen, sollten aber eigentlich auch keinen offenen Internetzugang haben. Dass etwas schief lief, merkte OpenAI zunächst aber nicht.
Wie darf man sich nun den Ablauf bei diesen Benchmarks vorstellen: Setzt OpenAI das Setup auf, gibt Anweisungen und Bedingungen mit auf den Weg und schaut dann irgendwann nach den Ergebnissen?
Jonas Geiping: OpenAI lässt es einfach als Benchmark laufen, weil sie oft neue Modelle testen oder neue Modelle bauen. Das ist eher alltägliches Business, bei dem jemand sagt: ‚Hier ist ein neuer Checkpoint, teste den mal auf unseren 753 Benchmarks.‘ Dann startet jemand den Test und schaut zwei Wochen später, ob er fertig ist und was die Ergebnisse sind. Das muss man sich glaube ich ganz banal vorstellen. Sie würden auch nicht diesen Benchmark überwachen, weil davon haben Sie im letzten Jahr schon viele Hunderte laufen lassen und es war immer Routine.
ComputerBase: OpenAI verspricht Besserungen beim Alignment – also dem Wertekosmos des Modells; je besser das Alignment ist, desto präziser hält es sich an die intendierten Vorgaben. Beim Start von GPT-6 Astra teilte OpenAI mit, basierend auf ExploitGym einen Benchmark gebaut zu haben, der testet, wie stark Modelle vom intendierten Verhalten abweichen. Bei GPT-5.6 Sol liegt der Wert der System Card zufolge 48,2 Prozent, bei GPT-6 Astra sind es null Prozent. Es ist also kein Vorfall im Benchmark-Test aufgetreten. Was macht man mit so einem Wert?
Jonas Geiping: Auf der einen Seite finde ich es sehr ehrlich von den Firmen, aber für uns von außen auch ein bisschen nutzlos. Natürlich hat OpenAI gesehen, wie chaotisch sich das Modell beim Hugging-Face-Hack verhalten hat. So etwas baut man dann nach und schaut, ob es beim nächsten Modell auch passiert. Das ist sinnvoll, sagt aber wenig drüber aus, in welchen anderen Fällen das Modell sich falsch verhalten würde. Es sagt nur, im gleichen Fall würde der Effekt nicht so nochmal auftauchen. Das ist jetzt wie ein Bug, der gepatcht wurde.
Aber auch die Stimmen aus der Industrie erklären, es ist immer schwer, fair zu sagen, was die nächste Schwachstelle ist. Die Idee von Agentenschwärmen war lange eher Science-Fiction und es gab ein bisschen Forschung dazu. Nun haben wir das gesehen. Die spannende Frage ist jetzt, was das nächste Ereignis ist. Wahrscheinlich werden es aber nicht die gleichen Agentenschwärme sein.
Die schwierige Kontrolle von Frontier-Modellen
ComputerBase: Das Chain-of-Thought-Monitoring – also praktisch die Echtzeitüberwachung der Gedankenkette eines Modells – wollen OpenAI und Anthropic nun ausbauen, um problematische Verhaltensweisen eher erkennen zu können. In der System Card von GPT-6 Astra beschreibt OpenAI allerdings, dass weniger Inhalte in der Chain-of-Thought landen, was laut Branchenbeobachtern das Monitoring erschwert. Lässt sich mit dem Chain-of-Thought-Monitoring also tatsächlich kontrollieren, was ein Modell macht, oder liest man im Endeffekt nur die Rechtfertigung des Modells?
Jonas Geiping: Eine schwierige Frage. Um es einfach zu erklären: Es gibt Operationen, die kann das Modell nicht in einem Schritt lösen, also in einem Token. Zum Beispiel eine Multiplikation von großen Zahlen. Es ist theoretisch unmöglich für das Modell, diese Aufgabe in einem Schritt zu lösen. Eben weil das Modell vielleicht 100 oder ein paar hundert Layer hat und mit diesen hundert Layern nicht mehr als 100 Zahlen addieren kann. Das ist nicht genau, aber ungefähr kann man das so gegenrechnen. Das heißt: Wenn das Modell eine komplexe Aufgabe löst, muss es irgendwann Zwischenschritte aufschreiben – in seinem Scratchpad, in seiner Chain of Thought. Deswegen ist das ein sehr wichtiges Ziel für das Monitoring. Aber andersrum betrachtet: Nur weil das Modell diese Schritte aufschreibt, heißt es nicht, dass wir diese Referenzen verstehen. Es sind Wörter, die wir lesen können, aber es muss jetzt nicht direkt mit menschlicher Sprache oder mit menschlichen Gedankengängen korrelieren.
Das können auch Referenzen sein, die das Modell für sich schreibt und die wir gar nicht so als Referenz sehen. So könnte das Modell etwas sagen wie „To solve this, I will“ und „I will solve this this way“. Die erste Aussage beschreibt dabei das Problem bei einem bestimmten Benchmark, die zweite ist das Problem eines anderen Benchmarks. Nur weil das Modell „to solve this, I will“ sagt, heißt es nicht, dass wir verstehen, was damit gemeint ist.
Eine weitere Diskussion betrifft die Modelltiefe. Wenn es mehr Layer hat, kann es größere Gedanken entwickeln und muss dadurch weniger in die Chain-of-Thought schreiben.
ComputerBase: Das bedeutet also, bei größeren Modellen sieht man Betrugsversuche schlechter – oder gibt es schlicht mehr davon?
Jonas Geiping: Das sind Dinge, die man getrennt sehen muss. Das eine ist, dass man die Chain-of-Thought schwerer lesen kann, weil sie größere Sprünge enthält. Und separat hat sich gezeigt, dass ein Modell bestimmte Verhaltensweisen entwickelt. Beides beobachten wir oft bei größeren Modellen, sind aber separate Effekte. So kann man sich ein Modell vorstellen, das sehr unehrlich agiert, aber eine sehr lange und sehr lesbare Chain-of-Thought hat – und das Gegenteil davon. Wenn beides zusammenkommt, ist es noch schwieriger zu verstehen, was es eigentlich macht und aus welchen Gründen es Entscheidungen trifft.
ComputerBase: Wie ehrlich und unehrlich ein Modell ist, beschreibt man wie erwähnt mit dem Alignment. Das ist so etwas wie die innere Kontrolle des Modells, durch die es von sich aus erkennt, was richtig und falsch ist. Ergänzt wird es durch äußere Kontrollschichten, die etwa Anfragen zu Themen wie Bioterrorismus oder Exploit-Entwicklungen blocken. Sie beschrieben bereits, dass aktuelle Frontier-Modelle durch Reinforcement Learning zu Problemlösern getrimmt wurden, was aber auch Schwachstellen wie das Reward Hacking als Konsequenz hat. Ist das Alignment mit den aktuellen Entwicklungs- und Trainingsmethoden überhaupt reparierbar?
Jonas Geiping: Das ist eine riesige Forschungsfrage. Es wird viel Zeit investiert, um das zu verbessern. Auf eine gewisse Art und Weise hat man den Eindruck, dass die Situation vor ein paar Jahren besser war. In 2023 und 2024 waren die Modelle mehr „alignt“. Durch das Reinforcement Learning, durch dieses lange Simulieren von Tausenden Problemen, die das Modell lösen muss, hat man etwas Alignment verloren.
Was dabei auch ein Problem ist: Viele dieser Simulationen hat man eingekauft und diese haben dann nicht immer eine so hohe Qualität. Diese Aufgaben sind dann beispielsweise unlösbar. Irgendwann erkennt das Modell das und versucht, etwas anders zu machen, um doch einen Punkt zu bekommen. Wo man also mehr machen kann, ist dem Modell keine unlösbaren Aufgaben zu geben und das Reinforcement Learning mehr als Phase zu verstehen, die das Alignment verändert und bei der man dann auch wieder eingreifen muss.
Wie groß das Risiko bei China-Modellen ist
ComputerBase: Nun haben wir die geschlossenen Modelle von OpenAI, Anthropic und Co. Es handelt sich also um Unternehmen, die grundsätzlich Konsequenzen zu befürchten haben. Demgegenüber stehen die offenen Modelle, also Open-Source-Varianten und die mit offenen Gewichten. Insbesondere die chinesischen Modelle wie Kimi KI und GLM 5.2 sorgten zuletzt immer wieder für Aufsehen, weil diese die Lücke zu den Frontier-Modellen in rund vier Monaten schließen. Wenn der Abstand nur wenige Monate beträgt: Haben offene Modelle zum Jahreswechsel dieselben Probleme wie die Frontier-Modelle heute, nur dann eben ohne zentrale Kontrollinstanz? Sind diese damit das größere Risiko?
Jonas Geiping: Da sind wir wieder beim Benchmaxxing. Es ist schwer abzuschätzen, was die Leistungsspanne der Open-Source-Modelle ist. Am einfachsten ist zu schauen, wie viele Nutzer hat beispielsweise ChatGPT jeden Tag und wie viele nutzen ein Kimi-Modell. Es gibt schon Nutzer von Open-Source-Modellen, aber ein großer Marktanteil ist es nicht. Es scheint schon so zu sein, dass die Modelle weiter hinterher hängen und viele Nutzer mehr zu den Closed-Source-Modellen tendieren, aber das kann sich natürlich noch ändern.
Ich denke schon, dass leistungsstarke und offene Modelle ein Risiko sein können. Spannenderweise sind aufgrund der Zentralisierung bislang wenige Fälle aufgetreten, wo es offene Modelle gibt, die vollkommen dezentral laufen. Die meisten Nutzer von Kimi K3 verwenden auch eine der Neo-Clouds oder so etwas wie OpenRouter, weil auch niemand ein Setup wie 16 H200-Karten im Keller hat, was etwa rund 500.000 bis 600.000 Euro entspricht. Deswegen laufen diese Modelle, selbst wenn sie offene Gewichte haben, über einen Provider, also so etwas wie OpenRouter oder Azure. Dort gibt es dann wieder Kontrollinstanzen und eine Verantwortung.
Natürlich könnte man Kimi K3 auf einem Laptop langsam laufen lassen und alle eingebauten Sicherheitsmechanismen deaktivieren, weil man die Gewichte hat. Aber aktuell ist das eher ein Hobby-Problem, einen solchen Fall gab es bislang nicht. Damit ist aber nicht in Stein gemeißelt, dass das Open-Source-Level sicher ist und in Zukunft nicht doch zu Problemen führt.
Dieser Artikel war interessant, hilfreich oder beides? Die Redaktion freut sich über jede Unterstützung durch ComputerBase Pro und deaktivierte Werbeblocker. Mehr zum Thema Anzeigen auf ComputerBase.
- 3DMark Steel Nomad + X
- Cinebench 2026
- Gears of War: E-Day (neu!)
- Apple M1 – M6
